~/blog/fr/homelab-soc-log-pipeline
Construire un SOC de homelab : un pipeline de journaux, huit tableaux de bord
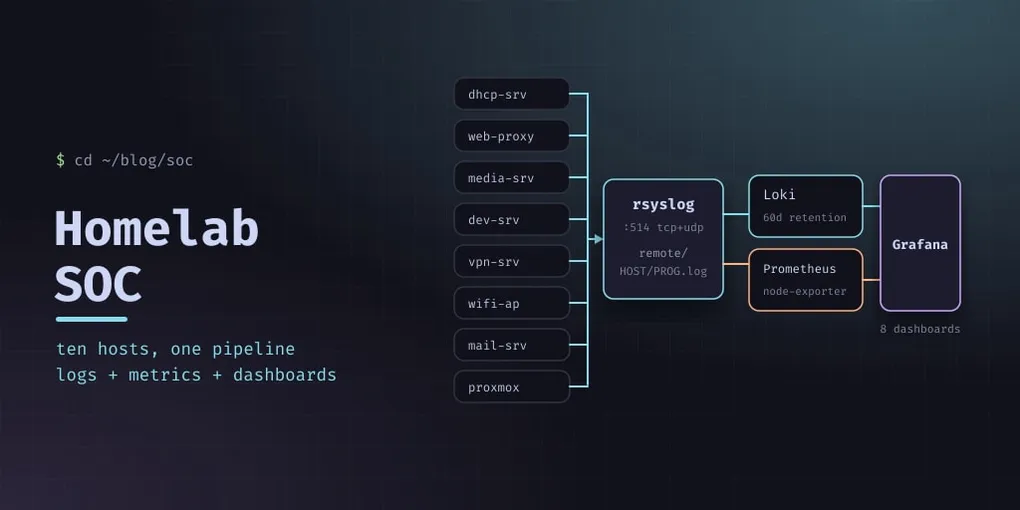
Un homelab, c’est une douzaine de machines, chacune écrivant ses propres journaux sur son propre disque, où personne ne les lit jamais. Dès que quelque chose va mal, vous vous connectez en SSH aux conteneurs un par un, en lançant journalctl et grep, en essayant de vous rappeler quelle machine était concernée.
Voici le pipeline qui a réglé ça : dix machines qui expédient leurs journaux au même endroit, les métriques à côté, et huit tableaux de bord que j’ouvre réellement.
La forme
dhcp-srv    ─┐
web-proxy   ─┤
mon-srv     ─┤
media-srv   ─┤   rsyslog            ┌─ Loki ─────┐
dev-srv     ─┼── :514 ──→  mon-srv ─┤            ├─ Grafana
vpn-srv     ─┤    (UDP+TCP)         └─ Prometheus ┘
wifi-ap     ─┤                          ↑
ai-srv      ─┤                          │ node-exporter sur chaque hôte
mail-srv    ─┘                          │
proxmox ────┘                    Frigate ─┘
Deux collecteurs, parce que les journaux et les métriques répondent à des questions différentes et qu’aucun ne remplace l’autre. Loki détient le pourquoi ; Prometheus détient le combien, depuis combien de temps, combien de fois. Grafana lit les deux, et pouvoir placer un panneau de métrique à côté d’un panneau de journaux est toute la raison de faire tourner les deux plutôt qu’un seul.
Le collecteur
rsyslog est déjà installé sur tout système Debian, ce qui en fait l’agent de journaux le moins cher possible. Sur le collecteur, trois lignes en font un serveur :
module(load="imudp")
input(type="imudp" port="514")

module(load="imtcp")
input(type="imtcp" port="514")
Les deux transports, parce qu’ils échouent différemment : UDP est fire-and-forget et laissera tomber des messages en silence sous charge, TCP bloque l’expéditeur quand le collecteur est occupé. Pour un labo, accepter les deux et laisser chaque client choisir est la réponse pragmatique.
Puis le template — et c’est la ligne qui rend les données exploitables :
$template RemoteLogs,"/var/log/remote/%HOSTNAME%/%PROGRAMNAME%.log"
*.* ?RemoteLogs
Des fichiers par hôte et par programme. Un unique remote.log avec tout entremêlé est un fichier que vous ne lirez jamais ; /var/log/remote/web-proxy/nginx.log est un fichier que vous lirez. Cela rend aussi la rétention et la suppression gérables plus tard.
imklog est délibérément désactivé. Il lit le buffer circulaire du noyau, auquel un conteneur ne peut pas accéder sans CAP_SYSLOG — vous obtenez des erreurs de permission et aucun message du noyau. Sur un collecteur conteneurisé, les journaux du noyau doivent venir de l’hôte Proxmox à la place, c’est pourquoi l’hôte lui-même est l’une des dix sources.
Le répertoire grossit sans bruit : le mien contient 3,4 Go de fichiers de journaux par programme. C’est acceptable, mais c’est un chiffre à mettre sur un tableau de bord plutôt qu’à découvrir.
Les clients
La règle client par défaut est toute la configuration pour la plupart des conteneurs :
*.* @@10.99.99.10:514 # @@ = TCP, un seul @ serait de l'UDPMais deux choses ne passent pas par syslog par défaut, et les deux comptent.
Les journaux applicatifs écrits dans des fichiers. nginx écrit dans /var/log/nginx/*.log, pas dans syslog, donc le client utilise imfile :
module(load="imfile")

input(type="imfile"
      File="/var/log/nginx/access.log"
      Tag="nginx-access"
      Severity="info"
      Facility="local6")

input(type="imfile"
      File="/var/log/nginx/error.log"
      Tag="nginx-error"
      Severity="error"
      Facility="local6")
Postfix tourne en chroot, donc son socket syslog n’est pas là où rsyslog écoute. Une ligne fait le pont :
$AddUnixListenSocket /var/spool/postfix/dev/logSans cela, les journaux du serveur mail lui-même ne quittent jamais la machine — et Postfix est exactement le service dont vous voulez les journaux centralisés quand la délivrabilité tourne mal.
Enfin, un ensemble de règles séparé pour le flux des analyses web, le journal d’accès JSON de nginx :
ruleset(name="fwd_nginx_analytics") {
    action(type="omfwd" target="10.99.99.10" port="514" protocol="tcp")
}
Il transfère ce fichier et rien d’autre : pas de copie dans le syslog local, et sa propre file d’attente, pour qu’un retard sur le flux le plus volumineux ne ralentisse jamais le reste.
Expédier dans Loki avec Alloy
Le collecteur suit le répertoire de journaux distants une seule fois et pousse vers Loki. C’était Promtail auparavant ; Alloy est son remplacement — même travail, un seul binaire qui gère aussi les métriques et les traces :
loki.source.file "remote_logs" {
  targets = [{
    __address__ = "localhost",
    __path__    = "/var/log/remote/*/*.log",
    job         = "remote_syslog",
  }]
  forward_to = [loki.process.remote_logs.receiver]

  file_match { enabled = true }
  legacy_positions_file = "/var/lib/promtail/positions.yaml"
}
Deux détails valent la peine d’être repris. file_match fait découvrir à Alloy les fichiers de journaux qui apparaissent après son démarrage — les journaux d’un nouveau conteneur sont pris en compte sans rechargement, ce que vous voulez dans un labo où les machines vont et viennent. Et réutiliser le fichier de positions de Promtail signifie que la migration ne renvoie pas tous les fichiers de journaux existants depuis le début, ce qui sur 3,4 Go est la différence entre une migration et un incident.
Les étiquettes sont attachées au passage. Chaque fichier reçoit remote_host et log_file d’après son chemin ; le flux d’accès web reçoit aussi un pays, tiré de la base GeoLite2 que CrowdSec télécharge déjà, et une étiquette traffic (humain, bot ou moi-même) :
stage.match {
  selector = "{log_file=\"nginx-analytics.log\"}"

  stage.json  { expressions = { ip = "ip", ua = "ua" } }
  stage.geoip {
    db      = "/var/lib/crowdsec/data/GeoLite2-City.mmdb"
    db_type = "city"
    source  = "ip"
  }
  stage.labels { values = { country = "geoip_country_code" } }
}
Une étiquette dérivée de GeoIP transforme « qu’est-ce qui tape sur le proxy » en une requête plutôt qu’en un grep sur des fichiers rotés.
Loki lui-même n’indexe que les étiquettes, pas le contenu, ce qui le rend économique : l’index reste petit, et la recherche plein texte est un parcours sur une plage temporelle bornée. Le paramètre qui décide de votre budget disque est la rétention :
limits_config:
  retention_period: 1440h   # 60 days
Soixante jours est un chiffre réfléchi. Assez long pour répondre à « quand cela a-t-il commencé », assez court pour qu’un conteneur bavard ne remplisse pas le disque avant que vous ne le remarquiez.
Métriques
node-exporter sur chaque machine, scrapé par Prometheus — les hôtes du labo, plus le serveur public hors du réseau local :
scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['10.99.99.1:9100']    # l'hyperviseur
      - targets: ['10.99.99.10:9100']   # le collecteur, qui se surveille lui-même
      - targets: ['10.99.99.11:9100']   # le proxy inverse
      # …one per container
Incluez le collecteur dans sa propre liste de cibles. Une pile de surveillance incapable de vous montrer son propre disque qui se remplit, c’est ainsi qu’une surveillance meurt sans que personne ne le remarque.
Les machines hors du réseau local sont scrapées de la même manière, mais en TLS avec authentification basique — node-exporter est un inventaire lisible par machine d’un hôte (noyau, points de montage, services), donc il ne devrait jamais être ouvert sur une interface publique :
  - job_name: node-public
    scheme: https
    basic_auth:
      username: prometheus
      password_file: /etc/prometheus/public-server-exporter.pass
    tls_config:
      ca_file: /etc/prometheus/public-server-exporter.crt
Tout ce qui peut répondre sur /metrics rejoint le pipeline de la même façon — y compris le NVR des caméras, qui expose des métriques Prometheus sur un port local et apparaît donc dans Grafana à côté des hôtes sur lesquels il tourne.
Les tableaux de bord
Huit, chacun répondant à une question que je pose réellement :
| Tableau de bord | La question |
|---|---|
| Vue d’ensemble du parc | Est-ce que chaque machine est up, et est-ce que quelque chose est sur le point de manquer de disque ? |
| Serveur Public | Le VPS est-il sain vu de l’extérieur ? |
| Analyse de Journaux | Qu’est-ce qui est le plus journalisé, et qu’est-ce qui a changé aujourd’hui ? |
| Vue d’ensemble Sécurité | Qu’est-ce qui m’attaque, et est-ce que quelque chose est bloqué ? |
| Analyse CrowdSec | Quels scénarios se déclenchent, depuis quels pays, contre quel service |
| Analyses Web | Qui lit les sites — depuis les journaux d’accès, sans tracking côté client |
| WiFi Maison | Quels clients ont rejoint le réseau sans fil, et qu’ont-ils résolu ? |
| Caméra | Les flux des caméras sont-ils vivants et détectent-ils ? |
Deux d’entre eux valent la peine d’être signalés parce qu’ils viennent de données que j’avais déjà :
Les Analyses Web sont construites à partir des journaux d’accès nginx dans Loki — comptages de visiteurs, référents, codes de statut, pas de JavaScript, pas d’analytics tiers, et aucune obligation de bannière cookies, parce que rien n’est stocké sur la machine du visiteur. Mes propres requêtes sont étiquetées internal d’après leur IP à l’ingestion et filtrées, et les liens entre mes propres sites sont exclus des référents.
WiFi Maison joint les événements sans fil aux requêtes DNS du conteneur du point d’accès. Les arrivées et départs de clients arrivent en syslog ; les résolutions de domaines malveillants connus sont rapportées par un petit service qui surveille le journal de requêtes du résolveur, en logfmt, alerte-seulement — le pipeline les enregistre, rien n’est bloqué, et le tableau de bord montre quel appareil a demandé quoi.
Alerte-seulement est un choix de conception délibéré : un bloqueur silencieux qui finit par bloquer quelque chose de légitime est pire qu’un signal que vous pouvez investiguer.
Ce qui a fait fonctionner le tout
- rsyslog partout, parce qu’il est déjà là — aucun agent à installer sur dix machines.
- Une disposition de fichiers par hôte et par programme sur le collecteur, pour que l’archive reste navigable même sans l’interface.
- TCP par défaut, UDP seulement là où une ligne perdue n’a pas d’importance.
- Des étiquettes à l’écriture (hôte, programme, geoip), parce que vous ne pouvez pas les ajouter rétroactivement.
- Une rétention fixée volontairement. La valeur par défaut n’est pas une décision.
- Les deux sources dans un même panneau. Un pic de métrique à côté de ses propres lignes de journal, c’est tout le bénéfice.
Pièges
imklogdans un conteneur nécessiteCAP_SYSLOG; sans lui vous obtenez des erreurs et aucun message du noyau. Expédiez plutôt les journaux de l’hyperviseur.- Le socket chroot de Postfix. Ajoutez
$AddUnixListenSocket /var/spool/postfix/dev/logsinon les journaux du mail restent locaux. - Un seul fichier de journal distant combiné. Des répertoires par hôte dès le départ.
- Des pertes UDP sous charge. Si un flux compte, envoyez-le en TCP.
- Oublier
file_matchsignifie que les nouveaux fichiers de journaux sont invisibles jusqu’au redémarrage d’Alloy. - Renvoyer l’historique lors d’une migration Promtail — réutilisez le fichier de positions.
- Une rétention non bornée. La taille de l’index et des chunks ne fait que croître.