~/blog/fr/homelab-patching-ansible-unattended-upgrades
Mettre à jour un homelab : la sécurité automatique, le reste à dessein
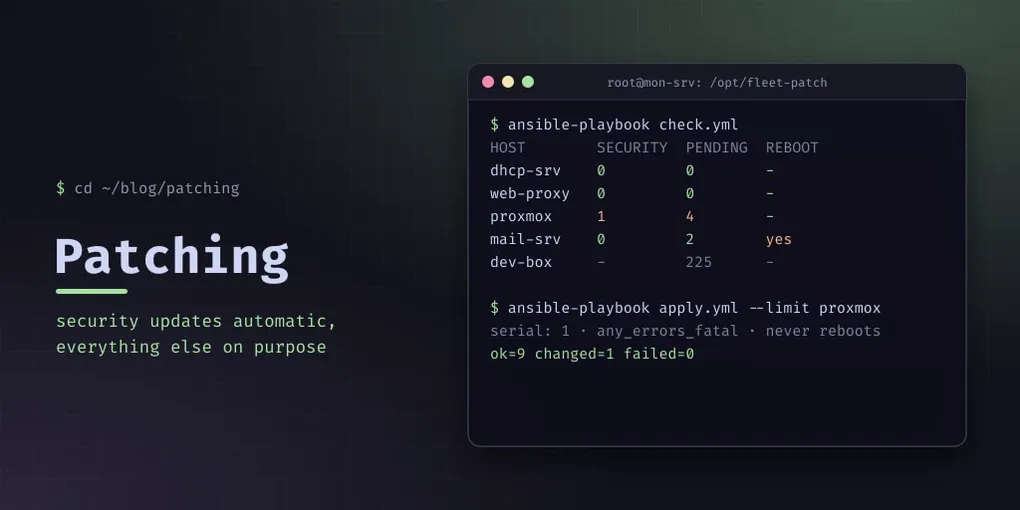
Quand j’ai installé un scanner de vulnérabilités, la première question à laquelle il a répondu ne portait pas sur les vulnérabilités. Elle portait sur moi : à part le serveur public, aucune machine du lab ne se mettait à jour toute seule. Tout était mis à jour quand je pensais à lancer apt upgrade, c’est-à-dire en pratique quand autre chose cassait. Le même correctif de sécurité libexpat1 attendait sur les dix hôtes.
La solution n’était pas « activer les mises à jour automatiques partout ». Des machines différentes peuvent se permettre des modes de défaillance différents, donc ce billet est d’abord une politique, et ensuite un outillage.
La politique
| Machines | Mises à jour | Pourquoi |
|---|---|---|
| Conteneurs | Debian-Security, automatiquement, chaque matin. Rien d’autre. | Les mises à jour de sécurité de Debian stable sont petites et prudentes. Un conteneur qui casse touche un seul service. |
| Hôte Proxmox | Manuelles, via un playbook | Une mise à jour du noyau ou de pve-* peut demander un redémarrage, et redémarrer l’hôte relance tous les conteneurs. |
| Serveur public | Valeurs par défaut de Debian (sécurité + versions intermédiaires), automatiquement | Il est exposé à Internet, il était donc déjà configuré ainsi et le reste. |
| Portable de dev (Kali, rolling) | Rapport seulement | Les distributions rolling cassent à leur propre rythme. Je veux voir le compteur, pas qu’il change sous mes pieds. |
| Dépôts tiers (Grafana, Wazuh, Docker) | Jamais automatiques | Leurs mises à jour changent le comportement, elles ne font pas que corriger. Le serveur et les agents Wazuh doivent être mis à jour dans un ordre précis. |
Deux règles traversent tout le tableau : rien ne redémarre automatiquement, et les paquets qui demandent un ordre sont bloqués (apt-mark hold), si bien que ni le timer ni moi ne pouvons les mettre à jour par accident.
Conteneurs : unattended-upgrades, restreint
Le unattended-upgrades de Debian est le bon outil. Ses origines par défaut incluent toutefois les versions intermédiaires, et je voulais la sécurité seule. Un fichier complémentaire, trié après le 50unattended-upgrades de Debian, remplace la liste :
// /etc/apt/apt.conf.d/52fleet-security-only
#clear Unattended-Upgrade::Origins-Pattern;
Unattended-Upgrade::Origins-Pattern {
        "origin=Debian,codename=${distro_codename}-security,label=Debian-Security";
        "origin=Debian,codename=${distro_codename},label=Debian-Security";
};
Unattended-Upgrade::Automatic-Reboot "false";
Unattended-Upgrade::Remove-Unused-Dependencies "false";
Unattended-Upgrade::SyslogEnable "true";
#clear est la ligne qui compte. Sans elle, apt fusionne les listes, et vos origines sont ajoutées à celles de Debian au lieu de les remplacer. Oui, c’est une directive qui ressemble à un commentaire.
20auto-upgrades active l’exécution quotidienne (APT::Periodic::Unattended-Upgrade "1";), et apt-daily-upgrade.timer la lance vers 6 h. Vérifiez ensuite ce qu’elle autorisera vraiment :
unattended-upgrade --dry-run --debug 2>&1 | grep -A3 "Allowed origins are"Sur mon conteneur de supervision, cela n’affichait que les origines Debian-Security, et le dépôt Wazuh marqué « not allowed ». C’est cette seconde partie que je voulais voir.
Tout le reste : un playbook Ansible
Le conteneur de supervision avait déjà des clés SSH vers tous les hôtes, il est donc devenu le contrôleur Ansible : ansible-core depuis Debian, un inventaire en quatre groupes (containers, pve, public, laptop), et trois playbooks :
check.ymlest en lecture seule : mises à jour en attente, le nombre de mises à jour de sécurité, les paquets bloqués et le drapeau de redémarrage pour chaque hôte.apply.ymlmet à jour.auto-security.ymlinstalle la configuration unattended-upgrades ci-dessus sur les conteneurs.
apply.yml est conçu pour s’arrêter plutôt que continuer :
- name: Upgrade
  hosts: "{{ target | default('patchable') }}"
  serial: 1                  # one host at a time
  any_errors_fatal: true     # first failure stops the run
  tasks:
    - name: Failed units before
      ansible.builtin.command: systemctl list-units --failed --plain --no-legend --no-pager
      register: failed_before
      changed_when: false
      check_mode: false

    - name: Upgrade
      ansible.builtin.apt:
        upgrade: dist
        dpkg_options: force-confdef,force-confold

# ...then "Failed units after", and fail if the difference is not empty- Un hôte à la fois, arrêt à la première erreur. Un mauvais paquet casse une machine, pas dix.
- Une nouvelle unité systemd en échec compte comme un échec. Une mise à jour qui « réussit » mais laisse un service mort est la plus dangereuse.
force-confoldgarde les fichiers de configuration locaux. Une exécution sans surveillance ne doit jamais s’arrêter sur une question de dpkg, ni remplacer en silence une configuration que j’ai modifiée.- Il ne redémarre jamais. Il affiche
/var/run/reboot-required.pkgspar hôte, et c’est moi qui décide. - Le portable est exclu par défaut. Il ne tourne qu’avec
-e target=<nom>.
La première exécution sur l’hôte Proxmox a installé quatre paquets, sans redémarrage nécessaire, sans nouvelle unité en échec, et avec tous les conteneurs toujours en marche.
Le dry run qui ne listait rien
ansible-playbook apply.yml --check affichait une liste de paquets vide sur chaque hôte. En mode check, Ansible saute les tâches command, parce qu’il ne peut pas savoir qu’elles sont inoffensives, et mon étape « qu’est-ce qui attend » était une commande. Les tâches en lecture seule ont besoin de check_mode: false pour tourner pendant un dry run. Sans cela, le dry run vous dit qu’il n’y a rien en attente.
Rendre visible une mise à jour oubliée
Une politique qu’on ne voit pas est une politique qu’on cessera de vérifier. Le paquet Debian prometheus-node-exporter-collectors ajoute un collecteur apt à node-exporter, qui écrit apt.prom toutes les 15 minutes :
apt_upgrades_pending{arch="amd64",origin=". stable:stable/stable"} 1
node_reboot_required 0
Une série par origine ayant quelque chose en attente. Les origines de sécurité contiennent -security, et c’est là-dessus que filtrent les requêtes ci-dessous. Cet exemple est le dépôt Grafana, qui n’est jamais mis à jour automatiquement.
Installez-le sans les recommandations. Avec elles, ipmitool tire openipmi, dont le script d’init échoue à chaque démarrage dans un conteneur sans matériel IPMI. Je l’ai découvert sous la forme d’une mystérieuse unité en échec sur un hôte.
Un détail PromQL m’a pris du temps : un hôte sans rien en attente n’a aucune série apt_upgrades_pending, il disparaît donc des tableaux au lieu d’afficher 0. Complétez par des zéros à partir d’une série que tous les hôtes ont :
sum by (host) (apt_upgrades_pending{origin=~".*-security.*"})
  or on (host) 0 * max by (host) (node_reboot_required)
Le Fleet Overview de Grafana a désormais une section Mises à jour : mises à jour de sécurité en attente, hôtes à redémarrer, toutes les mises à jour en attente par serveur, et le compteur du portable à part.
Et une alerte, Security Updates Pending : des mises à jour Debian-Security en attente sur un hôte depuis 72 heures. Sur un conteneur, cela veut dire qu’unattended-upgrades est cassé, puisqu’il aurait dû tourner trois fois. Sur l’hôte Proxmox ou le serveur public, cela veut dire qu’il est temps de lancer le playbook.
Deux petites choses le gardent honnête :
apply.ymlrelance le collecteur apt après la mise à jour, si bien que le tableau de bord se met à jour au prochain scrape. Sinon, il affiche l’ancien compteur jusqu’à 15 minutes, et on croit que la mise à jour a échoué.- Le même paquet a activé les métriques SMART sur l’hôte Proxmox, où
smartmontoolsétait déjà installé. Cela s’est révélé important : le SSD de l’hôte est en train de lâcher.
Pièges
#clearn’est pas un commentaire. Sans lui, vos origines s’ajoutent à celles de Debian au lieu de les remplacer.- Vérifiez les origines autorisées avec
--dry-run --debug, en particulier que les dépôts tiers sont refusés. --checksaute les tâchescommand. Les tâches en lecture seule ont besoin decheck_mode: false.- Bloquez les paquets qui doivent être mis à jour dans un ordre. Un agent plus récent que son serveur est refusé.
- Installez
prometheus-node-exporter-collectorssans les recommandations dans les conteneurs. - Pas de série, ce n’est pas zéro. Complétez les métriques par hôte, sinon les hôtes sans rien en attente disparaissent des tableaux.
- Les redémarrages automatiques sont une décision, pas une valeur par défaut. Sur un hyperviseur, un redémarrage est une coupure pour tout ce qui tourne dessus.